파이썬으로 네이버 쇼핑 커넥트 자동화하기 — 블로그 포스팅부터 인스타그램 릴스 자동 게시까지
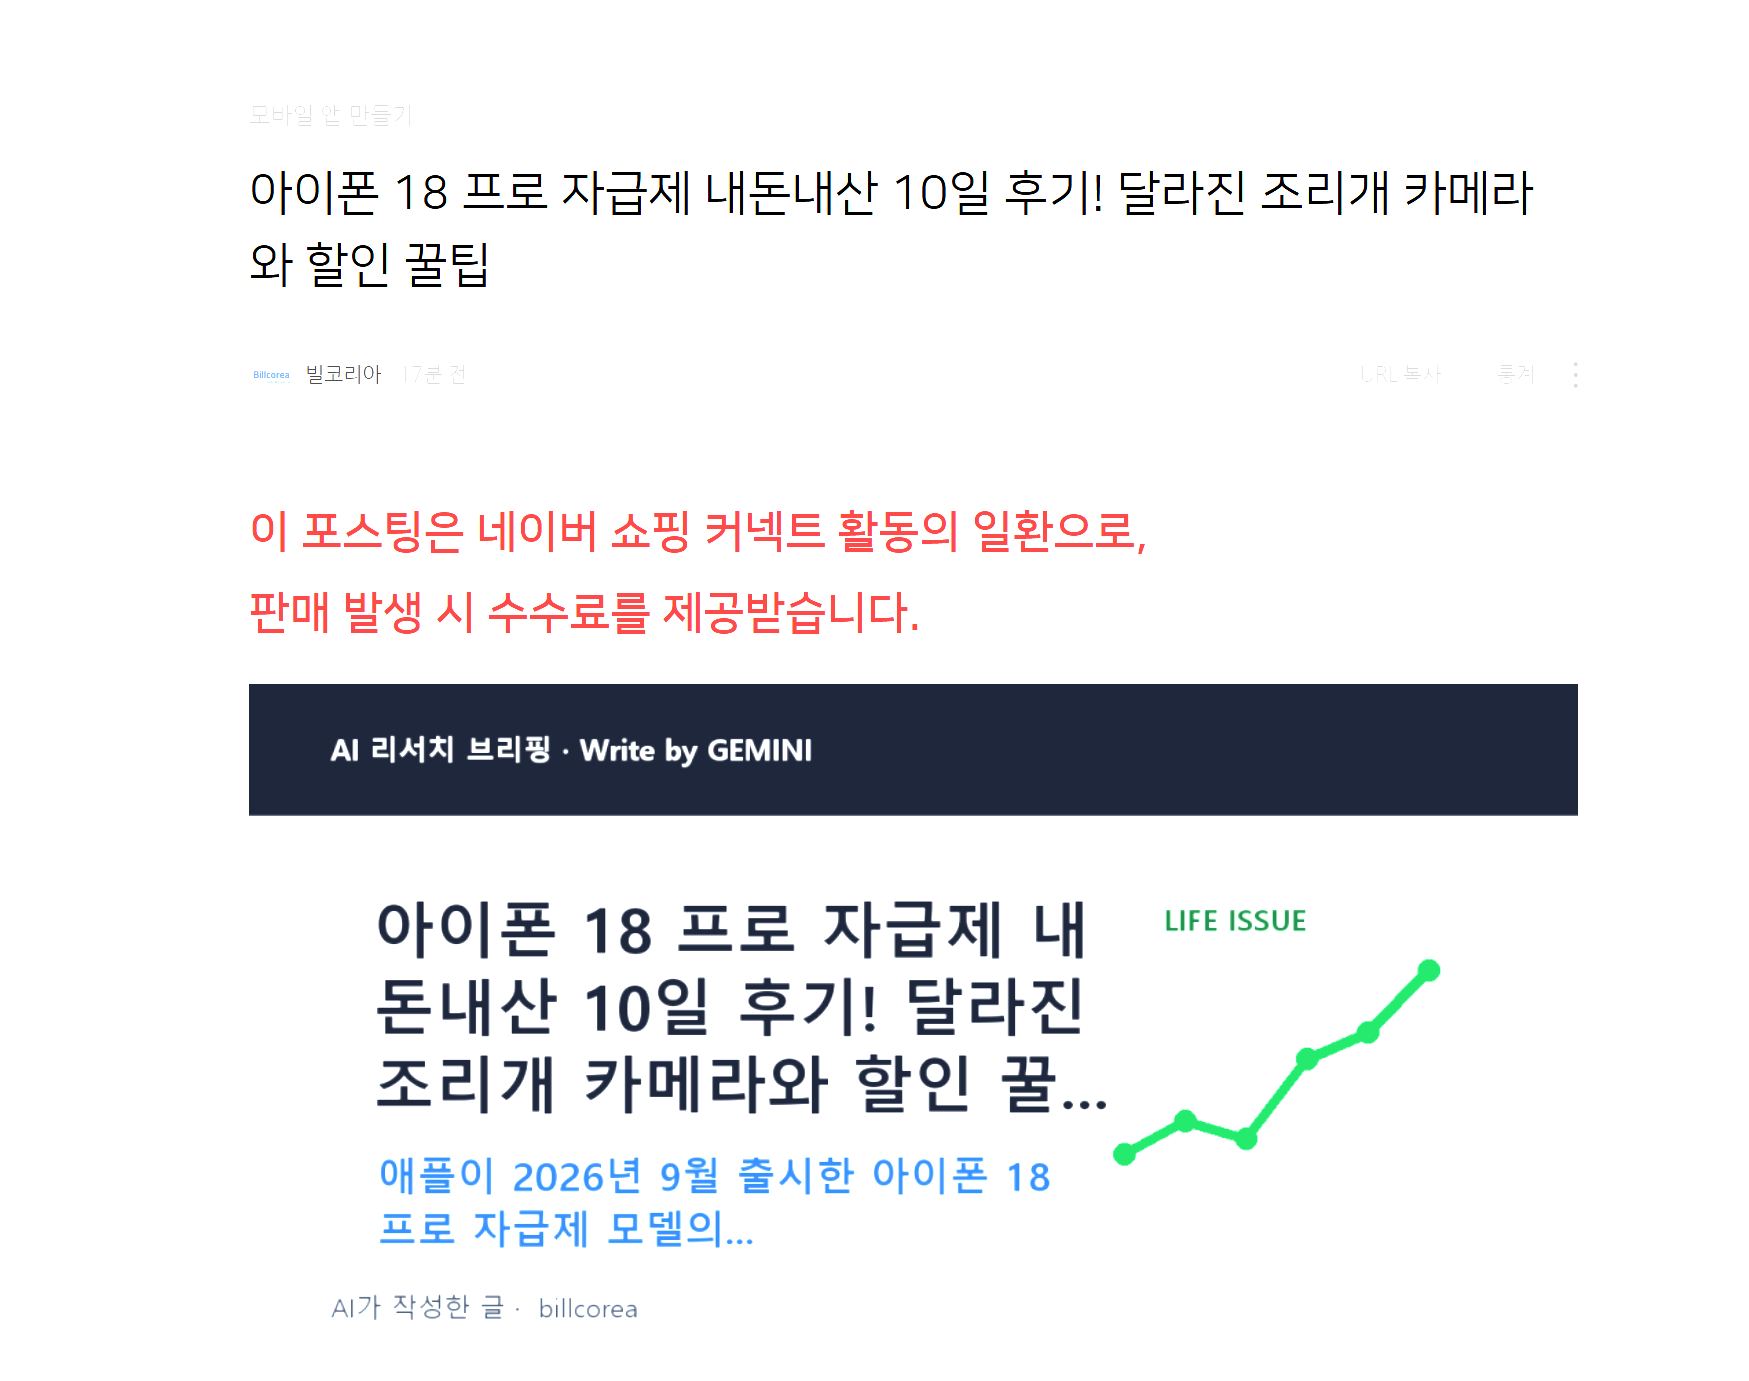
네이버 쇼핑 커넥트(브랜드 커넥트 제휴)로 받은 상품 링크를 블로그 글에 자동으로 붙이고, 같은 상품으로 인스타그램 릴스 영상까지 만들어 올리는 파이썬 자동화를 만들어 본 기록입니다. 중간에 겪은 삽질(PowerShell 쉼표, URL 인코딩, 에디터가 스타일을 지우는 문제 등)도 함께 정리했습니다.
⚠️ 쇼핑 커넥트는 공개 Open API 가 없습니다. 이 글은 본인 계정으로 로그인한 브라우저가 호출하는 요청을 그대로 재현하는 방식이라, 응답 형식이 예고 없이 바뀔 수 있고 운영 정책상 제한될 수 있습니다. 호출 빈도를 낮게 유지하고, 사용 전 브랜드 커넥트 운영정책을 꼭 확인하세요.
전체 구조
[쇼핑 커넥트]
   │  (로그인 쿠키로 내부 API 호출)
   ├─▶ 상품 조회 / 검색 / 제휴 링크 발급 ─▶ [네이버 블로그 봇] 글 상단 대가성 문구 + 하단 상품 목록
   │
   └─▶ 발급된 링크 목록 ─▶ sqlite 저장
                              │
                              ├─▶ 상품 이미지 → 세로 영상(ffmpeg) + 자막
                              └─▶ 인스타그램 Graph API 로 릴스 게시 (라즈베리파이 cron)
사용한 것: Python 3.9+, requests, playwright, beautifulsoup4, ffmpeg, firebase-admin(토큰·영상 임시 저장), sqlite.
1. 공개 API 가 없을 때: Playwright codegen 으로 흐름 녹화하기
먼저 "사람이 클릭하는 순서"를 코드로 뽑아봤습니다. Playwright 의 codegen 은 브라우저에서 한 동작을 파이썬 코드로 기록하고, 로그인 세션(쿠키)도 파일로 저장해 줍니다.
python -m playwright codegen --target python --save-storage=auth.json -o recorded.py https://brandconnect.naver.com/로그인 → 상품 찾기 → 상품 클릭 → "링크 발급" → "링크 복사" 까지 한 번 해 보면 이런 코드가 나옵니다.
page.goto("https://brandconnect.naver.com/<SPACE_ID>/affiliate/products")
page.get_by_role("link", name="상품 찾기").click()
with page.expect_popup() as info:
    page.get_by_role("link", name="수수료 5% 판매가 ...").click()
detail = info.value
detail.get_by_role("button", name="링크 발급").click()
detail.get_by_role("button", name="확인").click()
🚨 주의: codegen 은 입력한 값을 그대로 기록합니다. 로그인 과정까지 녹화하면 아이디·비밀번호가 평문으로 파일에 남습니다. 녹화 직후 로그인 부분을 지우고, 그 파일은 절대 커밋/공유하지 마세요. 저는 녹화 후 비밀번호를 바꿨습니다.
auth.json(로그인 쿠키)도.gitignore에 꼭 넣어 두세요.
또 하나 배운 점: 네이버 로그인은 자동화하면 캡차(영수증 문제 등)가 뜹니다. 로그인은 사람이 하고, 저장된 세션만 재사용하는 구조가 가장 안정적입니다.
2. 버튼 대신 API: 네트워크 요청 캡처
"링크 복사"는 클립보드로만 들어가서 코드로 값을 읽기 애매합니다. 그래서 링크 발급 버튼을 누를 때 어떤 요청이 나가는지 기록했습니다.
log = []

def on_response(resp):
    req = resp.request
    if "gw-brandconnect" not in req.url:
        return
    log.append({
        "method": req.method, "url": req.url, "status": resp.status,
        "post": req.post_data, "body": resp.text()[:3000],
    })

context = browser.new_context(storage_state="auth.json")
context.on("response", on_response)
요청 헤더에는 쿠키가 들어 있으니, 로그로 남길 때
cookie같은 헤더는 가리는 게 좋습니다.
캡처 결과, 화면 뒤에서는 이런 요청들이 오가고 있었습니다(도메인 gw-brandconnect.naver.com, 헤더 x-space-id: <SPACE_ID>).
| 용도 | 요청 |
|---|---|
| 상품 단건 | GET /affiliate/query/affiliate-products/{상품ID} |
| 추천 상품 | GET /affiliate/query/affiliate-products/recommend-by-shopping-promotions?category1Id=&limit= (limit 최대 10) |
| 상품 검색 | GET /affiliate/query/affiliate-products/search-by-query?query=&limit= |
| 링크 발급 | POST /affiliate/command/affiliate-urls?affiliateProductId={상품ID} 바디 {} |
| 발급 링크 목록 | POST /affiliate/query/affiliate-urls/search |
재미있던 점은 상품 응답에 이미 shortenUrl 필드가 있다는 것. 발급 전엔 null, 발급 후엔 https://naver.me/xxxx 가 들어 있어서, 굳이 클립보드를 읽을 필요가 없었습니다.
그리고 인증은 네이버 로그인 쿠키(NID_AUT, NID_SES)만 있으면 충분했습니다(쿠키가 없으면 403). 덕분에 Playwright 없이 requests 만으로도 호출할 수 있습니다.
삽질 포인트: 추천 상품 API 에
limit=20을 보냈더니400 ConstraintViolationException. 웹 화면이 보내는 값(10)을 넘기면 안 됩니다. 캡처한 값 그대로 쓰기가 기본입니다.
3. 클라이언트 만들기: 이미 있으면 재사용, 없을 때만 발급
Playwright 의 storage_state(JSON) 쿠키를 requests 세션에 싣는 부분입니다.
import json
import requests

def build_session(auth_path: str, space_id: str) -> requests.Session:
    state = json.loads(open(auth_path, encoding="utf-8").read())
    s = requests.Session()
    for c in state.get("cookies", []):
        s.cookies.set(c["name"], c["value"], domain=c.get("domain"), path=c.get("path", "/"))
    s.headers.update({
        "accept": "application/json, text/plain, */*",
        "x-space-id": space_id,
    })
    return s
링크 발급은 중복 발급을 막는 것이 핵심입니다. 로컬 캐시 → 상품 응답의 shortenUrl → (그래도 없으면) 발급 순서로 확인하고, 하루 발급 상한과 호출 간격도 둡니다.
GW = "https://gw-brandconnect.naver.com"

def get_or_issue_link(s, product: dict, cache: dict, today: str, daily_limit: int = 10) -> str:
    pid = str(product["id"])
    if cache["links"].get(pid):                 # 1) 로컬 캐시
        return cache["links"][pid]
    if product.get("shortenUrl"):               # 2) 이미 발급된 링크
        cache["links"][pid] = product["shortenUrl"]
        return product["shortenUrl"]
    if cache["issues"].get(today, 0) >= daily_limit:
        raise RuntimeError(f"오늘 발급 상한({daily_limit}) 도달")

    r = s.post(f"{GW}/affiliate/command/affiliate-urls",   # 3) 새로 발급
               params={"affiliateProductId": pid}, json={}, timeout=20)
    if r.status_code in (401, 403):
        raise RuntimeError("로그인 세션 만료 - 직접 다시 로그인해 쿠키 파일을 교체하세요")
    r.raise_for_status()
    url = r.json()["url"]                      # {"affiliateUrlId": ..., "url": "https://naver.me/..."}
    cache["links"][pid] = url
    cache["issues"][today] = cache["issues"].get(today, 0) + 1
    return url
테스트는 실제 발급이 일어나지 않도록 가짜 request 객체로 작성했습니다.
class FakeRequest:
    def __init__(self, products):
        self.products = {p["id"]: p for p in products}
        self.posts = 0

    def post(self, url, **kw):
        self.posts += 1
        return FakeResp(200, {"affiliateUrlId": 1, "url": f"https://naver.me/new{self.posts}"})
4. 블로그 본문에 넣기: "빨간 대가성 문구"가 사라지는 문제
쇼핑 커넥트는 게시글에 대가성 문구를 눈에 띄게 넣어야 합니다. 그래서 글 맨 위에 빨간 글씨로 넣었는데… 발행해 보니 검은 글씨가 됐습니다.
원인은 제 코드였습니다. 티스토리/AI 가 만든 HTML 을 네이버 스마트에디터에 붙여 넣기 전에 정리하는 sanitize 함수가 <span> 을 풀고 모든 style 을 지우고 있었습니다(에디터가 잘라내는 태그를 줄이려는 의도였음).
해결: 표시(data-keep-color)가 달린 span 만 색/크기를 남기는 예외를 만들었습니다.
import re
from bs4 import BeautifulSoup

KEEP_COLOR = re.compile(r"(?<![-\w])color\s*:\s*(#[0-9a-fA-F]{3,6}|rgb\([\d\s,]+\)|[a-zA-Z]+)")
KEEP_SIZE = re.compile(r"font-size\s*:\s*(\d+(?:\.\d+)?(?:px|pt|em|rem|%))")

def sanitize(html: str) -> str:
    soup = BeautifulSoup(html, "lxml")
    for tag in list(soup.find_all(["div", "span"])):
        if tag.name == "span" and tag.has_attr("data-keep-color"):
            continue                      # 표시된 span 은 남김
        tag.unwrap()
    for span in soup.find_all("span"):
        style = span.get("style", "")
        kept = []
        if m := KEEP_COLOR.search(style):
            kept.append(f"color:{m.group(1)};")
        if m := KEEP_SIZE.search(style):
            kept.append(f"font-size:{m.group(1)};")
        span.attrs = {"style": "".join(kept)} if kept else {}
    return str(soup.body.decode_contents())

disclosure = (
    '<p><span data-keep-color="1" style="color:#e03131;font-size:30px;">'
    "<strong>이 포스팅은 네이버 쇼핑 커넥트 활동의 일환으로,</strong><br>"
    "<strong>판매 발생 시 수수료를 제공받습니다.</strong></span></p>"
)
에디터가 정말 색을 유지했는지는 붙여 넣은 뒤 DOM 의 계산된 스타일로 확인하면 확실합니다.
color = frame.evaluate("""(needle) => {
    const w = document.createTreeWalker(document.body, NodeFilter.SHOW_TEXT);
    let n;
    while ((n = w.nextNode())) {
        if (n.nodeValue.includes(needle)) {
            const cs = getComputedStyle(n.parentElement);
            return cs.color + " / " + cs.fontSize;
        }
    }
    return null;
}""", "쇼핑 커넥트 활동의 일환으로")
print(color)   # rgb(224, 49, 49) / 30px
대표 이미지가 문구보다 위로 올라가는 문제
이미지는 커서 위치에 업로드되는데, 본문을 넣은 뒤 제목을 입력하느라 커서가 제목에 있었습니다. 그래서 이미지가 본문 맨 앞(문구 위)에 꽂혔죠. 업로드 직전에 커서를 문구 끝으로 옮겨서 해결했습니다.
def place_cursor_after_disclosure(page, last_line="판매 발생 시 수수료를 제공받습니다."):
    for fr in page.frames:
        loc = fr.get_by_text(last_line, exact=False)
        if loc.count():
            loc.first.click()
            page.keyboard.press("End")
            return True
    return False
상품 썸네일이 안 보이는 문제
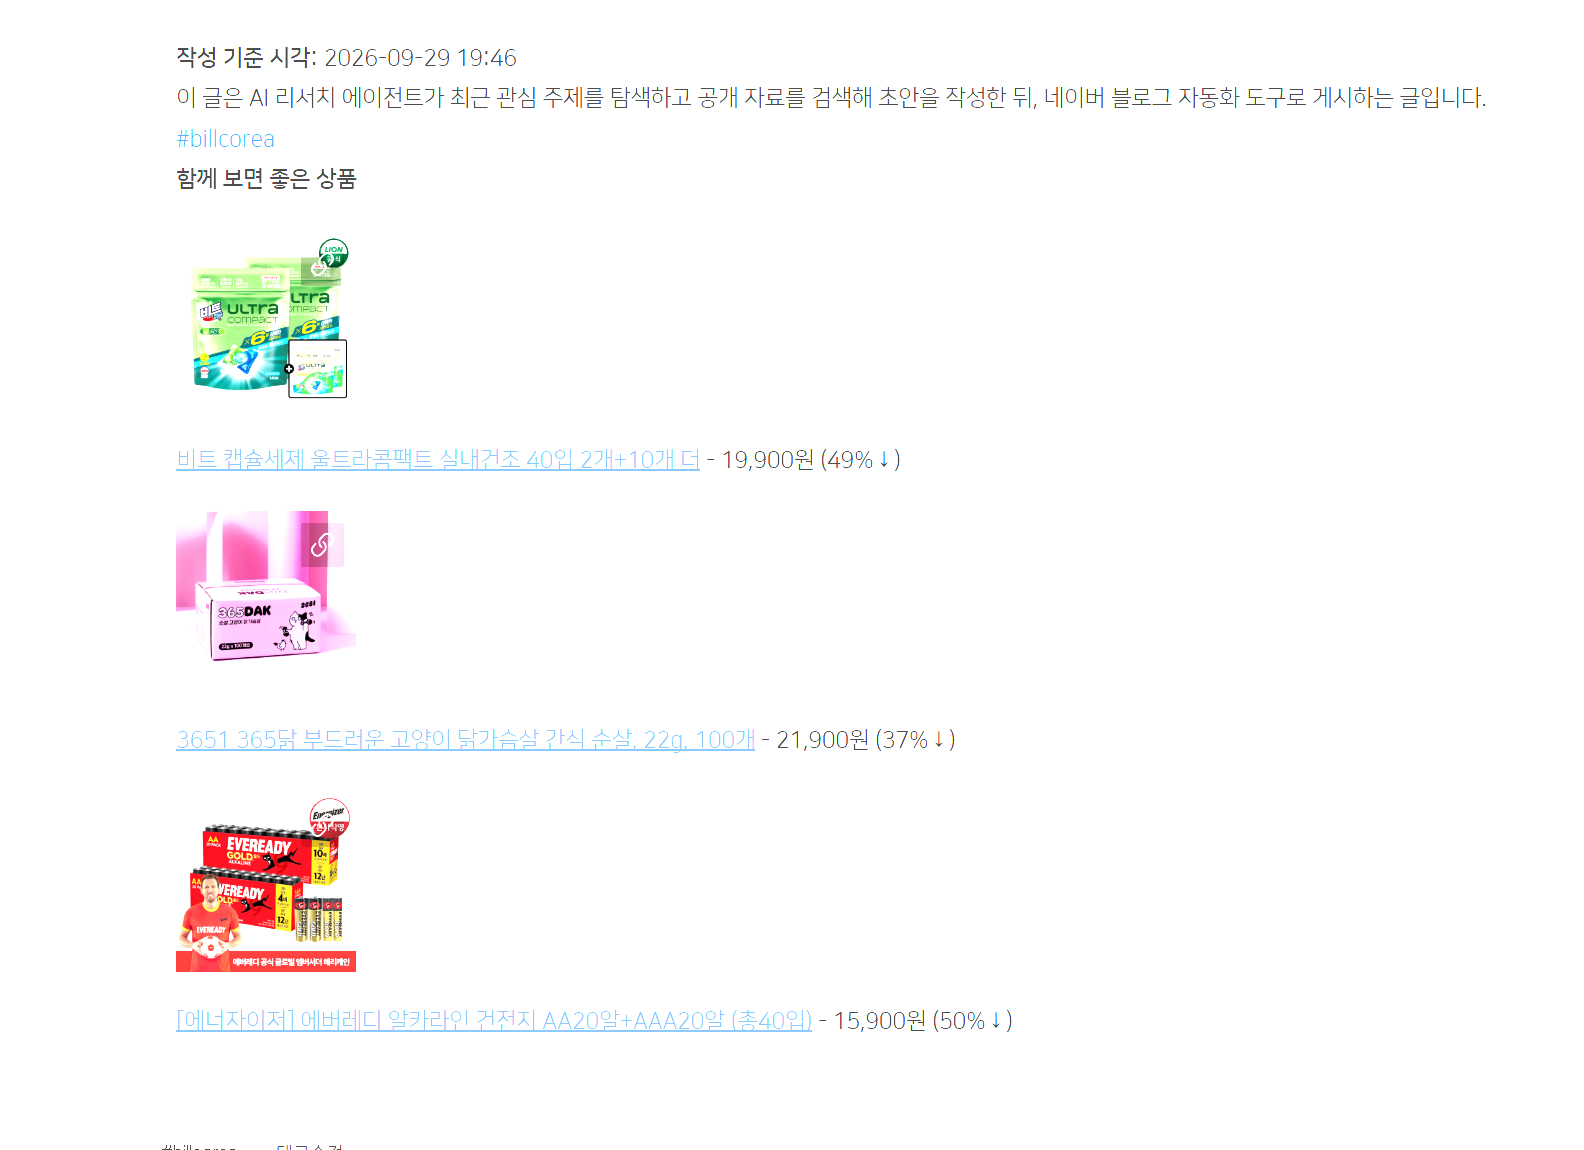
상품 이미지도 같은 표시 방식(data-keep-img)으로 살렸는데, 이번엔 이미지만 들어 있는 <p> 가 통째로 비워졌습니다. "텍스트 없는 문단은 빈 줄로 만든다"는 기존 로직이 이미지를 못 본 것.
# 전: 텍스트도 <br> 도 없으면 비움 -> <p><a><img></a></p> 가 날아감
if not p.get_text(strip=True) and not p.find(["br"]):
# 후: 이미지가 있으면 건드리지 않음
if not p.get_text(strip=True) and not p.find(["br", "img"]):
5. 글 주제와 관련된 상품 고르기
처음엔 카테고리 추천 상품을 넣었더니 "전기요금 절약" 글에 냄비 세트가 붙는 참사가… 그래서 글을 쓰는 AI 에게 상품 검색어도 같이 달라고 했습니다.
- shopping_keywords 에는 이 글을 읽은 독자가 실제로 구매할 만한, 주제와 직접 관련된
  상품 검색어 3~5개를 연관도가 높은 순서로 넣습니다. 쇼핑몰 검색창에 그대로 넣을
  짧은 명사형(1~2단어, 예: "가습기", "무선 청소기")으로 쓰고, 브랜드명·수식어는 넣지 않습니다.
키워드 순서대로 검색해서 품절·중복을 빼고 모으고, 관련 상품이 부족해도 엉뚱한 상품으로 채우지 않습니다.
def search_candidates(client, keywords, per_keyword=10):
    seen, out = set(), []
    for kw in keywords:
        for p in client.search(kw, limit=per_keyword):
            if p.is_linkable and p.id not in seen:   # 판매중 + 활성 + 스토어 정상
                seen.add(p.id)
                out.append(p)
    return out
실제 검색 결과: "가습기" → 미니 가습기, "무선 청소기" → 무선청소기, "전기요금 절약" → 스마트 플러그. 훨씬 자연스러워졌습니다.
6. 기존 릴스 파이프라인에 방어 로직 넣기
이미 스레드 글을 릴스로 만드는 파이프라인(큐 동기화 → 영상 제작 → 게시)이 라즈베리파이 cron 으로 돌고 있었는데, 코드를 읽다 보니 위험한 곳이 보였습니다.
① 실패한 항목이 큐를 영원히 막는다. 매번 id 가 가장 작은 1건만 처리하는데, 그게 실패하면 다음 실행에도 또 그것만 시도합니다. → 실패 횟수와 재시도 시각을 기록하고, 3회면 큐에서 뺍니다.
from datetime import datetime, timedelta

MAX_ATTEMPTS = 3
BACKOFF = timedelta(minutes=30)

def record_failure(ref, item, error):
    count = int(item.get("build_fail_count") or 0) + 1
    update = {"build_fail_count": count, "last_build_error": str(error)[:500]}
    if count >= MAX_ATTEMPTS:
        update["status"] = "build_failed"          # 큐에서 제외
    else:
        update["build_retry_after"] = (datetime.now() + BACKOFF * count).isoformat(sep=" ", timespec="seconds")
    ref.update(update)

# 고를 때: 재시도 대기 중이면 건너뛰고, 실패 이력이 적은 것부터
candidates.sort(key=lambda kv: (int(kv[1].get("build_fail_count") or 0), queue_sort_key(kv[0])))
② 숫자가 아닌 키에서 int() 예외로 전체가 죽는다.
def queue_sort_key(key: str) -> tuple:
    raw = key[len("item_"):] if key.startswith("item_") else key
    try:
        return (0, int(raw), "")
    except ValueError:
        return (1, 0, key)          # 숫자 아닌 키는 뒤로
③ 토큰 만료 같은 "전체 장애"를 항목 실패로 세면 안 된다. 토큰이 만료되면 모든 항목이 3번씩 실패해서 큐가 통째로 비워집니다. Graph API 오류 코드로 구분했습니다.
GLOBAL_CODES = {190, 4, 17, 32, 613}   # 190: 토큰 무효, 나머지: 호출 제한

def raise_for_graph_error(r, what):
    if r.status_code == 200:
        return
    code = (r.json().get("error") or {}).get("code")
    if r.status_code >= 500 or code in GLOBAL_CODES:
        raise GlobalPostingError(f"{what}: {r.text[:300]}")   # 실패 횟수 X, 이번 실행만 중단
    raise Exception(f"{what}: {r.text[:300]}")                # 항목 실패로 기록
④ 동기화 경쟁 상태. "스레드에 아직 안 올라간(pending) 글만 릴스로 복사"로 바꿨더니, 스레드 봇이 먼저 게시해 버리면 영원히 복사가 안 되는 틈이 생겼습니다. 그래서 최근 1일 안에 게시된 글도 복사하도록 창을 열어 두었습니다.
⑤ 영상 파일이 계속 쌓인다. 게시가 끝난 항목의 로컬 mp4 는 지우도록 했습니다(자기가 만든 폴더 안의 파일만).
7. 상품 이미지로 세로 릴스 영상 만들기
상품 이미지는 대부분 정사각형이라 1080x1920 으로 그냥 늘리면 찌그러집니다. 흐린 배경 위에 원본 비율 그대로 얹는 ffmpeg 필터를 썼습니다.
import subprocess

def make_vertical_slide(src, dst, w=1080, h=1920):
    vf = (
        "split[a][b];"
        f"[a]scale={w}:{h}:force_original_aspect_ratio=increase,crop={w}:{h},boxblur=30:2[bg];"
        f"[b]scale={w}:{h}:force_original_aspect_ratio=decrease[fg];"
        "[bg][fg]overlay=(W-w)/2:(H-h)/2"
    )
    subprocess.run(["ffmpeg", "-y", "-i", str(src), "-filter_complex", vf,
                    "-frames:v", "1", "-q:v", "2", str(dst)], check=True)

def make_silence(dst, seconds):
    # 나레이션 없이 무음 트랙(업로드 호환용). 기존 조립 스크립트가 오디오 길이로 클립 길이를 정함
    subprocess.run(["ffmpeg", "-y", "-f", "lavfi", "-i", "anullsrc=r=44100:cl=stereo",
                    "-t", str(seconds), "-c:a", "libmp3lame", "-q:a", "9", str(dst)], check=True)
자막: 처음 3초는 빨간 대가성 문구, 그 뒤엔 상품명
자막은 SRT 로 만들고 ffmpeg subtitles 필터로 입힙니다. 여기서 알게 된 팁 두 가지:
- SRT 안의
<font color="...">,<b>는 ffmpeg 가 ASS 스타일로 변환해 줍니다. <font size="16">도 된다! 공용 스타일(force_style='Fontsize=22')은 다른 영상과 같이 쓰고 있어서 건드리기 싫었는데, SRT 태그로 이 영상만 크기를 덮어쓸 수 있었습니다. (참고로{\fs16}같은 ASS 태그는 ffmpeg 의 SRT 파서가{\an8}류 말고는 지워버립니다.)
DISCLOSURE = ("이 포스팅은 네이버 쇼핑 커넥트 활동의 일환으로,", "판매 발생 시 수수료를 제공받습니다.")

def srt_time(sec: float) -> str:
    ms = round(sec * 1000)
    h, ms = divmod(ms, 3_600_000)
    m, ms = divmod(ms, 60_000)
    s, ms = divmod(ms, 1000)
    return f"{h:02d}:{m:02d}:{s:02d},{ms:03d}"

def build_srt(name: str, total: float, disclosure_sec=3.0, size=16) -> str:
    disclosure = "\n".join(f'<font color="#e03131" size="{size}"><b>{line}</b></font>' for line in DISCLOSURE)
    product = name.replace("<", "(").replace(">", ")")   # 상품명이 태그로 해석되지 않게
    entries = [(0, min(disclosure_sec, total), disclosure)]
    if total > disclosure_sec:
        entries.append((disclosure_sec, total, f'<font size="{size}">{product}</font>'))
    return "\n".join(f"{i}\n{srt_time(a)} --> {srt_time(b)}\n{t}\n" for i, (a, b, t) in enumerate(entries, 1))
슬라이드가 1장뿐인 상품은 문구만 나오고 끝나지 않도록, 그 장의 길이를 (문구 3초 + 3초)로 늘렸습니다.
8. 인스타그램 릴스 게시: 중복 게시만은 막자
게시는 Instagram API(Instagram 로그인) 의 3단계 흐름입니다: 컨테이너 생성 → 처리 완료 대기 → 게시. 영상은 공개 URL 이 필요해서 Firebase Storage 에 잠깐 올렸다가 게시 후 지웁니다.
GRAPH = "https://graph.instagram.com/v21.0"

def create_container(ig_user_id, video_url, caption, token):
    r = requests.post(f"{GRAPH}/{ig_user_id}/media", data={
        "media_type": "REELS", "video_url": video_url, "caption": caption, "access_token": token,
    }, timeout=60)
    raise_for_graph_error(r, "컨테이너 생성 실패")
    return r.json()["id"]

def wait_until_processed(creation_id, token, timeout=300):
    start = time.time()
    while time.time() - start < timeout:
        r = requests.get(f"{GRAPH}/{creation_id}", params={"fields": "status_code", "access_token": token}, timeout=60)
        raise_for_graph_error(r, "상태 조회 실패")
        status = r.json().get("status_code")
        if status == "FINISHED":
            return
        if status == "ERROR":
            raise Exception("영상 처리 실패")
        time.sleep(5)
    raise Exception("영상 처리 타임아웃")
가장 무서운 건 "게시는 됐는데 응답을 못 받아서 다음 실행에 또 올리는" 중복 게시입니다. 그래서 게시 직전에 상태를 publishing 으로 찍고, 응답을 못 받으면 자동 재시도하지 않고 사람이 확인하게 했습니다.
set_status(conn, pid, "publishing")
try:
    media = publish(creation_id, token)
except GlobalPostingError:
    print("게시 결과를 확인하지 못했습니다. 인스타그램에서 확인 후 상태를 직접 바꿔 주세요.")
    return 1                      # publishing 으로 남김 -> 다음 실행에서 안 집음
set_posted(conn, pid, media)
캡션에는 가격, 제휴 링크, 대가성 문구, 해시태그를 넣었습니다. 인스타그램 캡션의 링크는 클릭이 안 되기 때문에 "복사해서 브라우저에 붙여 넣어 주세요" 안내를 같이 적었습니다.
9. Meta 개발자 설정 & 배포 삽질 모음
체크리스트
- 인스타그램 계정을 프로페셔널(비즈니스/크리에이터) 로 전환
- 앱이 개발 모드면 앱 역할 → Instagram 테스터에 계정 추가 → 인스타그램 앱에서 초대 수락
- 권한 및 기능에
instagram_business_content_publish추가 (기본 세팅엔 basic/comments/messages 만 있을 수 있음!) - Instagram 비즈니스 로그인 설정에 리디렉션 URL 등록
- 로그인 동의 → code → 단기 토큰 → 장기(60일) 토큰 교환 (저는 Cloud Functions 로 콜백을 처리)
삽질 1: 앱 ID 가 두 개다
대시보드 맨 위의 Meta 앱 ID 와, Instagram API 설정 화면의 Instagram 앱 ID 는 다릅니다. OAuth client_id 와 토큰 교환에는 Instagram 앱 ID 를 써야 합니다.
삽질 2: PowerShell 에서 --set-env-vars 가 하나로 합쳐짐
# ❌ 쉼표가 PowerShell 배열 구분자로 해석돼 "A=1 B=2 C=3" 한 덩어리로 넘어감
gcloud functions deploy my-func ... --set-env-vars=APP_ID=123,APP_SECRET=xxx,REDIRECT_URI=https://.../

# ✅ 인자 전체를 큰따옴표로 감싸기
gcloud functions deploy my-func ... "--set-env-vars=APP_ID=123,APP_SECRET=xxx,REDIRECT_URI=https://.../"
배포는 "성공"했는데 함수가 Server misconfigured 를 뱉어서 한참 헤맸습니다. 환경변수 이름 목록을 찍어보고서야 APP_ID 하나에 전부 들어간 걸 발견했어요.
삽질 3: redirect URI 인코딩은 "브라우저 주소에서만"
- 함수 환경변수 / 대시보드 등록값:
https://my-callback.example.run.app/(원래 형태, 끝/까지 똑같이) - 브라우저로 여는 동의 URL 안에서만:
redirect_uri=https%3A%2F%2Fmy-callback.example.run.app%2F
삽질 4: ID 가 두 개다 (또!)
OAuth 가 돌려주는 user_id 는 앱 범위 ID 이고, /me?fields=user_id 는 인스타그램 계정 ID(1784...) 를 줍니다. 같은 계정입니다. 토큰 점검 스크립트에서 둘 중 하나만 맞으면 통과하도록 했습니다.
me = requests.get(f"{GRAPH}/me", params={"fields": "id,user_id,username,account_type",
                                          "access_token": token}, timeout=20).json()
same_account = str(target_id) in (str(me.get("id")), str(me.get("user_id")))
토큰 자동 갱신
장기 토큰은 60일 뒤 만료됩니다. 만료 15일 전부터 cron 에서 자동 갱신하게 했습니다(발급 후 24시간이 지나야 갱신 가능).
r = requests.get("https://graph.instagram.com/refresh_access_token",
                 params={"grant_type": "ig_refresh_token", "access_token": token}, timeout=20)
new_token = r.json()["access_token"]
10. cron 등록
#!/bin/bash
cd /home/pi/myproject
# 이전 실행(영상 제작)이 길어져도 겹쳐 돌지 않게
exec 9>/tmp/reels_sc.lock
flock -n 9 || { echo "이전 실행 진행 중 - 건너뜀"; exit 0; }

python3 sync_products.py || echo "상품 동기화 실패(기존 DB 로 계속)"
python3 ig_token_check.py --refresh-if-needed
python3 build_reels.py
python3 ig_reels_posting.py
# 하루 2번, 다른 봇과 겹치지 않게 30분에
30 10,20 * * * /home/pi/myproject/reels_sc.sh >> /home/pi/myproject/reels_sc.log 2>&1
윈도우에서
.sh를 편집해 라즈베리파이로 보낼 땐 줄바꿈(CRLF) 을 조심하세요. PowerShellSet-Content로 고치면 CRLF 가 되어 bash 가 깨집니다.[IO.File]::ReadAllText/WriteAllText처럼 원본 줄바꿈을 유지하는 방법을 쓰세요.
마치며
정리해 보면 이번 작업에서 가장 도움이 된 원칙은 세 가지였습니다.
- 로그인은 사람이, 반복은 코드가 — 캡차·2단계 인증과 싸우지 말고 세션만 재사용하기
- 실패는 기록하고 격리하기 — 한 항목의 실패가 큐 전체를 막지 않게, 전체 장애는 항목 탓으로 세지 않게
- 중복 발행은 자동 재시도보다 무섭다 — 결과를 모르면 멈추고 사람에게 확인받기
그리고 codegen 녹화 파일, 쿠키 파일, 앱 시크릿은… 정말 조심하세요. 저는 이번에 둘 다 한 번씩 노출시키고 나서 비밀번호와 시크릿을 새로 바꿨습니다. 😅


댓글 없음:
댓글 쓰기